Tot mai multe cumpărături nu mai încep pe o pagină de rezultate. Oamenii îl întreabă pe ChatGPT, pe Gemini sau pe Perplexity de unde să cumpere ceva și se orientează după răspuns. Întrebarea proprietarului de magazin online este ce trebuie configurat pentru asta și dacă trebuie configurat ceva.
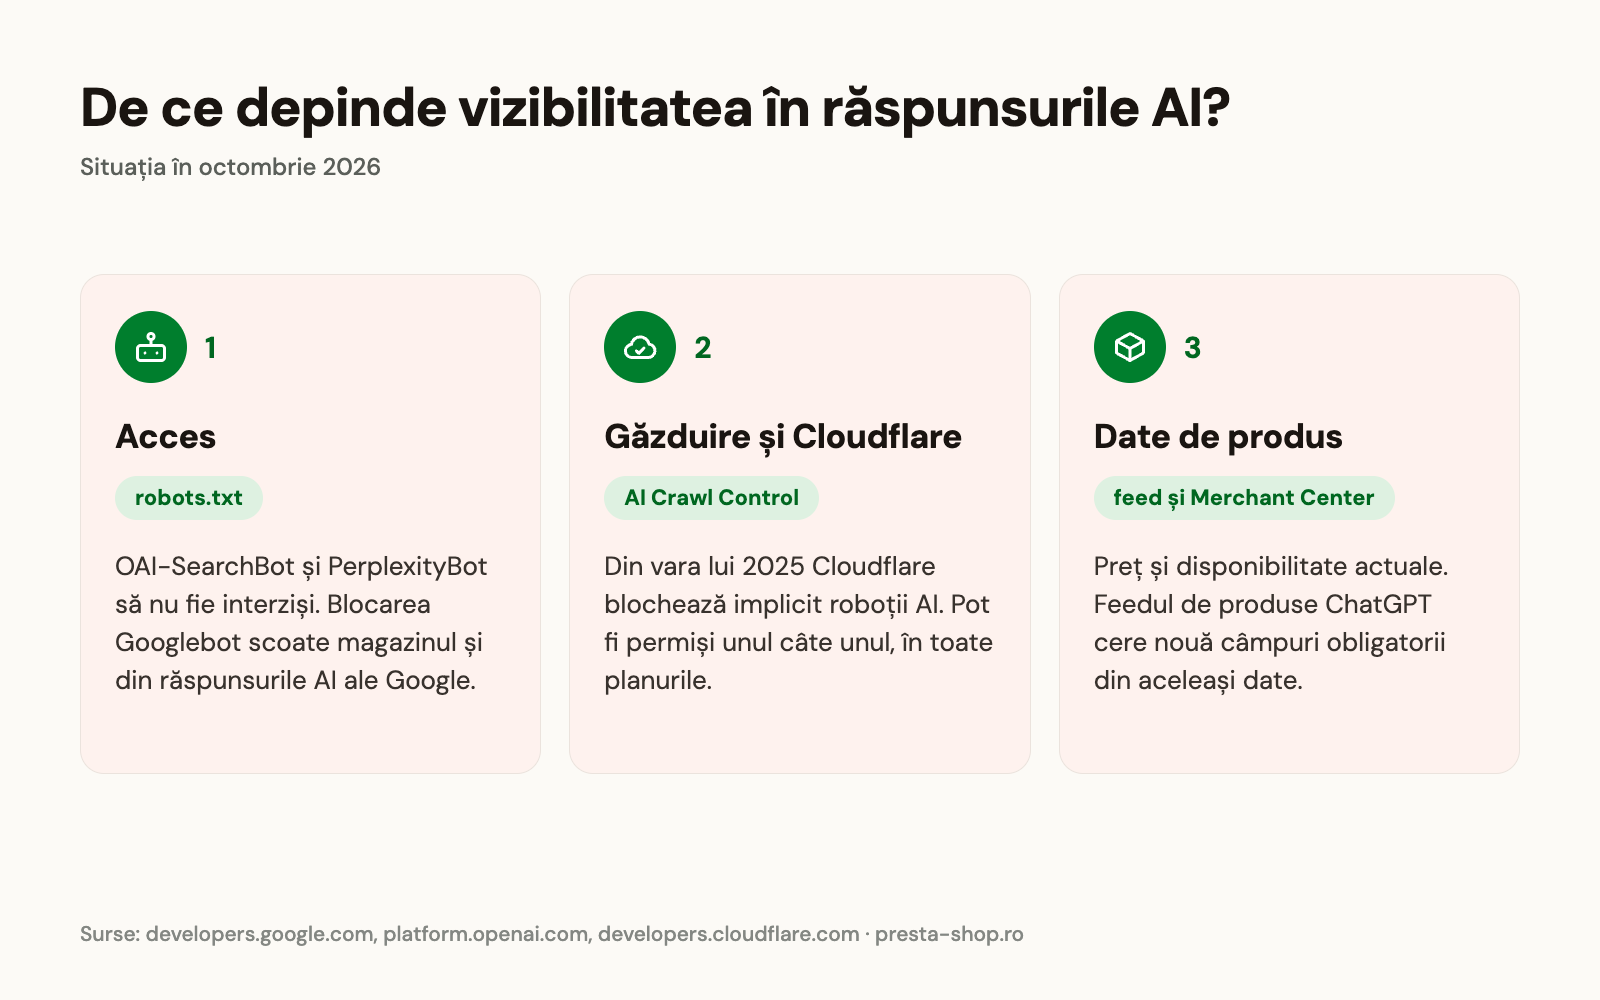
Răspunsul scurt: nu există o optimizare separată pentru AI, dar trei lucruri decid dacă magazinul poate fi menționat într-un astfel de răspuns. Dacă programul ajunge la paginile magazinului, dacă datele găsite acolo sunt actuale și dacă feedul de produse este pregătit pentru platformele care deschid propriul proces de comandă. Articolul trece prin ce spune documentația Google și OpenAI despre fiecare și ce merită verificat astăzi.
Nu vă pricepeți la tehnică?Pe scurt: de ce depinde vizibilitatea magazinului în AI?
Asistenții AI nu aleg dintr-o listă proprie. Citesc aceleași pagini pe care le citesc și motoarele de căutare și îi spun celui care întreabă ce au găsit acolo. Dacă paginile magazinului sunt accesibile și actuale, magazinul poate ajunge în răspuns. Dacă ceva le blochează accesul, nu.
Sunt două locuri în care blocarea apare din greșeală: fișierul robots.txt al magazinului și setările de protecție ale găzduirii sau ale Cloudflare. A doua este mai frecventă, pentru că în vara anului 2025 Cloudflare a făcut din blocarea roboților AI setarea implicită.
Prin urmare, nu trebuie create fișiere noi, ci verificat dacă există vreo blocare. Răspunsul îl are cel care întreține magazinul și furnizorul de găzduire.
Întrebări pentru cel care întreține magazinul și pentru găzduire
Fișierul robots.txt al magazinului interzice robotul OAI-SearchBot sau PerplexityBot? Pe găzduire sau în Cloudflare există o regulă activă care blochează roboții AI (AI Crawl Control, bot fight mode, o regulă WAF)? Dacă da, pe care roboți se aplică și de când? Datele de produs din Google Merchant Center sunt actuale, în special prețul și disponibilitatea?
Este nevoie de o optimizare separată pentru răspunsurile AI ale Google?
Nu. Documentația pentru dezvoltatori a Google o spune explicit: nu există cerințe suplimentare pentru ca o pagină să apară în AI Overviews sau în AI Mode și nu este necesară nicio optimizare specială. Pe aceeași pagină se mai spune că nu trebuie create fișiere noi citibile de mașini, fișiere text pentru AI sau marcaje pentru asta și că nu există date structurate schema.org speciale care ar trebui adăugate din acest motiv.
Condiția este alta: pagina să fie indexată și să poată fi afișată cu un fragment în căutarea Google. În plus, Google enumeră practici deja cunoscute, printre ele ca datele structurate să corespundă textului vizibil pe pagină și ca informațiile din Merchant Center să fie actuale.
Reciproca este la fel de valabilă și contează mai mult: ce scoate pagina din căutare o scoate și din răspunsurile AI. Potrivit Google, directivele robots.txt pentru Googlebot sunt instrumentul de control al accesului, iar cât se afișează din pagină este limitat de nosnippet, data-nosnippet, max-snippet și noindex. Un nosnippet setat din precauție scoate magazinul și din răspunsul AI.
Pe care roboți merită să îi lăsăm să intre?
În robots.txt contează ce este interzis explicit: ce nu apare în fișier este permis. Merită totuși știut la ce servește fiecare robot, pentru că nu toți răspund de afișare.
| Robot | La ce servește | Ce înseamnă dacă este blocat |
|---|---|---|
| OAI-SearchBot (OpenAI) | răspunsurile de căutare din ChatGPT | magazinul nu apare în răspunsurile de căutare din ChatGPT |
| GPTBot (OpenAI) | antrenarea modelelor | conținutul nu ajunge în antrenare; afișarea în căutare nu este afectată |
| ChatGPT-User (OpenAI) | deschide o pagină la cererea utilizatorului | regulile din robots.txt nu se aplică neapărat, pentru că vizita este inițiată de o persoană |
| PerplexityBot | afișarea și linkul în Perplexity | magazinul nu apare în răspunsurile Perplexity |
| Googlebot | căutarea Google și răspunsurile AI | magazinul iese din căutare și, odată cu ea, din răspunsurile AI |
| Google-Extended | antrenarea și fundamentarea răspunsurilor modelelor Gemini | potrivit Google nu afectează includerea în căutare și nu este factor de clasare |
Documentația OpenAI spune că setările sunt independente între ele: OAI-SearchBot poate fi permis pentru afișarea în căutare chiar dacă GPTBot este interzis. După modificarea fișierului, în căutarea ChatGPT schimbarea se aplică în aproximativ o zi.
Blochează găzduirea sau Cloudflare roboții AI?
Aceasta este cauza mai frecventă și nu se decide în magazin. Pe 1 iulie 2025 Cloudflare a anunțat că schimbă setarea implicită pe blocarea roboților AI atâta timp cât aceștia nu plătesc pentru conținut. Funcția se numește AI Crawl Control, este disponibilă în toate planurile, arată cât cere fiecare robot AI de pe site și permite sau blochează robot cu robot. Accesul plătit, pay per crawl, este deocamdată în beta privată.
În practică asta înseamnă că robots.txt al magazinului poate permite totul, iar cererea să nu ajungă deloc la magazin, pentru că a răspuns Cloudflare înaintea lui. O linie din robots.txt este o cerere, o regulă Cloudflare este o constrângere, de aceea cele două trebuie verificate separat. Firewallul găzduirii (WAF, protecție anti-bot) poate filtra la fel, iar acolo blocarea vine deseori dintr-o regulă generală, nu din numele unui robot AI.
Dacă magazinul este în spatele Cloudflare, ecranul AI Crawl Control arată rând cu rând care robot a primit blocare. Asta este totodată și măsurătoarea: un robot care nu apare în listă nici nu a încercat.
Cum ajung produsele în răspunsurile de cumpărare din ChatGPT?
Aici o pagină citibilă nu mai este suficientă. OpenAI cere un feed de produse separat, iar documentația sa spune că înscrierea feedurilor de produse în ChatGPT este disponibilă momentan partenerilor aprobați, pe bază de cerere. Deci, când se spune undeva că un magazin poate fi pur și simplu conectat la ChatGPT, merită știut că nu este o înscriere pe care o face oricine singur.
Structura feedului este însă publică și merită pregătită, pentru că se construiește din aceleași date pe care le cere și Google Shopping. Nouă câmpuri sunt obligatorii: item_id, title, description, url, brand, seller_name, image_url, availability și price. Ritmul recomandat este un feed complet pe zi, încărcat ca fișier, iar modificările din timpul zilei trimise prin API; datele despre promoții pot fi transmise exclusiv prin API.
Plata rămâne la comerciant. Potrivit documentației OpenAI, starea coșului și procesarea plății se întâmplă în sistemele comerciantului, iar OpenAI nu este vânzătorul comenzii. Magazinul nu cedează nimic din tranzacție, doar devine accesibil pe o suprafață nouă.
Prin urmare, pentru un magazin al cărui feed de Google Shopping nu este în ordine, următorul pas este feedul, nu AI-ul. Aceleași date, aceleași defecte: marcă lipsă, preț vechi, disponibilitate greșită. Modulul Export feed produse generează din aceeași sursă feedul pentru Google, Facebook și Compari, iar articolul nostru despre Merchant API descrie ce s-a schimbat în acest an la Google.
Are nevoie magazinul de un fișier llms.txt?
Pentru afișare, nu. Documentația Google citată mai sus spune explicit că nu trebuie create fișiere text pentru AI, iar niciun motor de căutare sau asistent nu îl menționează drept condiție. Site-uri mari de documentație, printre ele site-urile pentru dezvoltatori ale OpenAI și Cloudflare, publică un astfel de fișier, pentru că așa propria documentație se citește mai ușor cu un instrument AI, dar nu este factor de clasare sau de afișare.
Ajută la altceva: fișierul oferă o listă ordonată a conținutului magazinului, astfel încât devine mai previzibil ce găsește un program care citește. Pentru cine nu vrea să țină lista manual, modulul nostru generator llms.txt o actualizează singur din produse, categorii și pagini de informații. Ordinea nu se poate inversa însă: dacă roboții sunt blocați sau datele sunt vechi, fișierul nu ajută.
Cum se poate măsura traficul din răspunsurile AI?
Clicurile din răspunsurile AI ale Google apar în raportul de performanță din Search Console, la tipul de căutare „Web”, împreună cu restul clicurilor din căutare. Nu există un rând separat pentru AI, deci în Search Console nu se poate separa cât a venit de acolo.
Cealaltă direcție este analitica proprie: vizitatorul venit de pe o suprafață AI are ca referrer domeniul acelei suprafețe, de exemplu chatgpt.com sau perplexity.ai. Merită creat un segment sau un raport pentru acestea în Google Analytics 4, pentru că implicit se pierd în traficul de tip referral. Pe partea de publicitate, modulul ChatGPT Ads măsoară rezultatul reclamelor care rulează în ChatGPT, din browser și de pe server.
Ce nu merită făcut: să se dea un procent estimat al comenzilor venite din răspunsuri AI. Astăzi nu există o dată pe care magazinul să o poată citi din propriile instrumente pentru un astfel de număr.
Ce merită făcut acum?
- De deschis
robots.txtpe adresa magazinului (/robots.txt) și de căutat în el numeleOAI-SearchBot,GPTBot,PerplexityBot,Google-Extended. Dacă niciunul nu areDisallow, partea asta este în ordine. - De întrebat găzduirea sau de verificat Cloudflare, dacă vreo regulă blochează roboții AI. În Cloudflare, ecranul AI Crawl Control arată asta robot cu robot.
- De verificat indexarea în Search Console, pentru că o pagină neindexată nu poate apărea nici în răspunsul AI. Aici intră și un
nosnippetrămas din greșeală. - De pus în ordine feedul de produse (preț, disponibilitate, marcă, imagine), pentru că aceleași date sunt necesare și pentru Google Shopping și pentru un feed ChatGPT.
- De configurat măsurarea în Google Analytics 4 pentru referrerii suprafețelor AI, ca în lunile următoare să existe o bază de comparație.
Ce depășește asta este muncă de conținut, aceeași pe care o cere de mult optimizarea pentru căutare: nume de produs exacte, descrieri reale, atribute completate, date structurate care corespund paginii. Nu este nevoie de o tehnică nouă.
Întrebări frecvente
Dacă interzic GPTBot, dispar din răspunsurile ChatGPT?
Nu. Documentația OpenAI spune că setările sunt independente: GPTBot colectează pentru antrenare, iar de afișarea în căutare răspunde OAI-SearchBot. Cine îl interzice pe acesta din urmă iese din răspunsurile de căutare din ChatGPT.
Trebuie adăugat marcaj schema.org din cauza AI?
Potrivit Google nu există date structurate speciale care ar trebui adăugate din acest motiv. Pentru marcajul de produs existent, condiția este să corespundă textului vizibil pe pagină.
Se pot cumpăra astăzi produsele mele direct în ChatGPT?
Înscrierea feedului de produse este, potrivit documentației OpenAI, disponibilă momentan partenerilor aprobați, pe bază de cerere. Plata se face în sistemele comerciantului, iar OpenAI nu este vânzătorul comenzii.
De unde știu dacă un robot AI a trecut pe la magazin?
Din jurnalul de acces al găzduirii, căutând numele robotului, sau din lista AI Crawl Control din Cloudflare. Un robot care nu apare nicăieri nici nu a încercat.
Surse: Google Search: AI features and your website, Google: Common crawlers (Google-Extended), OpenAI: Bots, OpenAI Commerce: Get started, OpenAI Commerce: specificația feedului de produse, OpenAI Commerce: key concepts, Perplexity: Bots, Cloudflare: Content Independence Day, Cloudflare: AI Crawl Control

Comentarii
Încă nu există comentarii.